پیش‌نیازهای دستیار هوشمند سازمانی؛ از آماده‌سازی اسناد تا ارزیابی پاسخ

بررسی اسناد و منابع دانش برای راه‌اندازی دستیار هوشمند سازمانی
زمان مطالعه: 9 دقیقه

سازمانی را در نظر بگیرید که می‌خواهد کارکنانش پاسخ پرسش‌های کاری را از یک دستیار هوشمند بگیرند. اسناد هم موجودند: آیین‌نامه‌ها، راهنماهای محصول، فایل‌های آموزشی و گزارش‌ها. اما در اولین آزمایش، دستیار به نسخه قدیمی یک دستورالعمل استناد می‌کند یا پاسخ درست را از میان فایل‌ها پیدا نمی‌کند. مسئله از کجا شروع شده است؟
بخشی از پاسخ به آمادگی سازمان برمی‌گردد. پیش‌نیازهای دستیار هوشمند سازمانی شامل کاربرد روشن، منابع معتبر، دسترسی مشخص، زیرساخت متناسب و روش سنجش پاسخ است. در این راهنما، خروجی لازم برای هر بخش را مشخص می‌کنیم تا جلسه بررسی راهکار و اجرای آزمایشی، مبنای قابل سنجش داشته باشد.

اگر هنوز درباره محل اجرای مدل و کنترل داده‌ها تصمیم نگرفته‌اید، مقاله هوش مصنوعی داخل سازمانی چیست؟ نقطه شروع مناسبی برای شناخت Private AI است.

ابتدا مشخص کنید دستیار قرار است چه کاری انجام دهد

«دسترسی به تمام دانش سازمان» برای شروع، محدوده روشنی نیست. بهتر است یک کار پرتکرار انتخاب شود که هم منابع معتبر دارد و هم نتیجه آن قابل بررسی است؛ مثلاً کمک به کارشناسان خدمات برای یافتن دستورالعمل عیب‌یابی یک خانواده محصول.
برای این کاربرد، نام گروه کاربران، نوع سؤال، منابع مجاز و خروجی مورد انتظار را بنویسید. همچنین مشخص کنید دستیار فقط پاسخ پیشنهاد می‌دهد یا اجازه انجام عملیات هم دارد. نمایش دستورالعمل با تغییر وضعیت یک درخواست خدمات، مسئولیت و نیاز فنی متفاوتی دارد.
یک بریف اولیه می‌تواند چنین باشد: «کارشناس خدمات، پرسش فنی را مطرح کند و پاسخ همراه با بخش مرتبط از راهنمای معتبر بگیرد؛ پاسخ نهایی به مشتری را خود کارشناس تأیید کند.» در این محدوده، اتصال به همه سامانه‌ها ضرورت ندارد.

اگر مسئله، کاربران و معیار موفقیت هنوز روشن نیستند، از چک‌لیست نیازسنجی زیرساخت IT برای نظم‌دادن به جلسه اولیه استفاده کنید.

اسناد را برای استفاده واقعی آماده کنید

نسخه معتبر و مسئول هر منبع را تعیین کنید

پیشنهاد عملی این است که برای هر مجموعه سند، مسئول تأیید محتوا تعیین شود. این فرد باید بتواند بگوید کدام نسخه معتبر است، چه چیزی تغییر کرده و چه زمانی بازبینی بعدی لازم است.
برای مثال، وجود دو فایل با نام‌های «راهنمای نهایی» و «راهنمای نهایی جدید» ابهام را برطرف نمی‌کند. عنوان مشخص، شناسه سند، تاریخ اعتبار و وضعیت تأیید کمک می‌کند نسخه قابل استفاده معلوم باشد. اسناد منسوخ نیز باید از جست‌وجوی جاری کنار گذاشته شوند یا با وضعیت روشن، فقط برای کاربرد تاریخی در دسترس باشند.

خوانایی متن، جدول و فایل‌های فارسی را آزمایش کنید

یک PDF اسکن‌شده ممکن است برای انسان خوانا باشد، اما استخراج متن آن به OCR، یعنی تشخیص متن از تصویر، نیاز داشته باشد. قبل از ورود گسترده فایل‌ها، چند نمونه واقعی را بررسی کنید: آیا شماره مدل، واحد اندازه‌گیری، ترتیب ستون‌ها و رابطه عنوان با متن درست استخراج می‌شوند؟

در اسناد فارسی، شکل‌های مختلف «ی» و «ک»، نیم‌فاصله و نام انگلیسی محصولات را هم در آزمون جست‌وجو بگنجانید. هدف، یافتن همان محتوایی است که کارشناس با بیان‌های مختلف درباره آن سؤال می‌کند. راهنمای آماده‌سازی داده برای RAG در Microsoft نیز بر بررسی قالب، ساختار و نمونه‌های نماینده محتوا تأکید دارد.

نقش RAG در پاسخ‌گویی از اسناد چیست؟

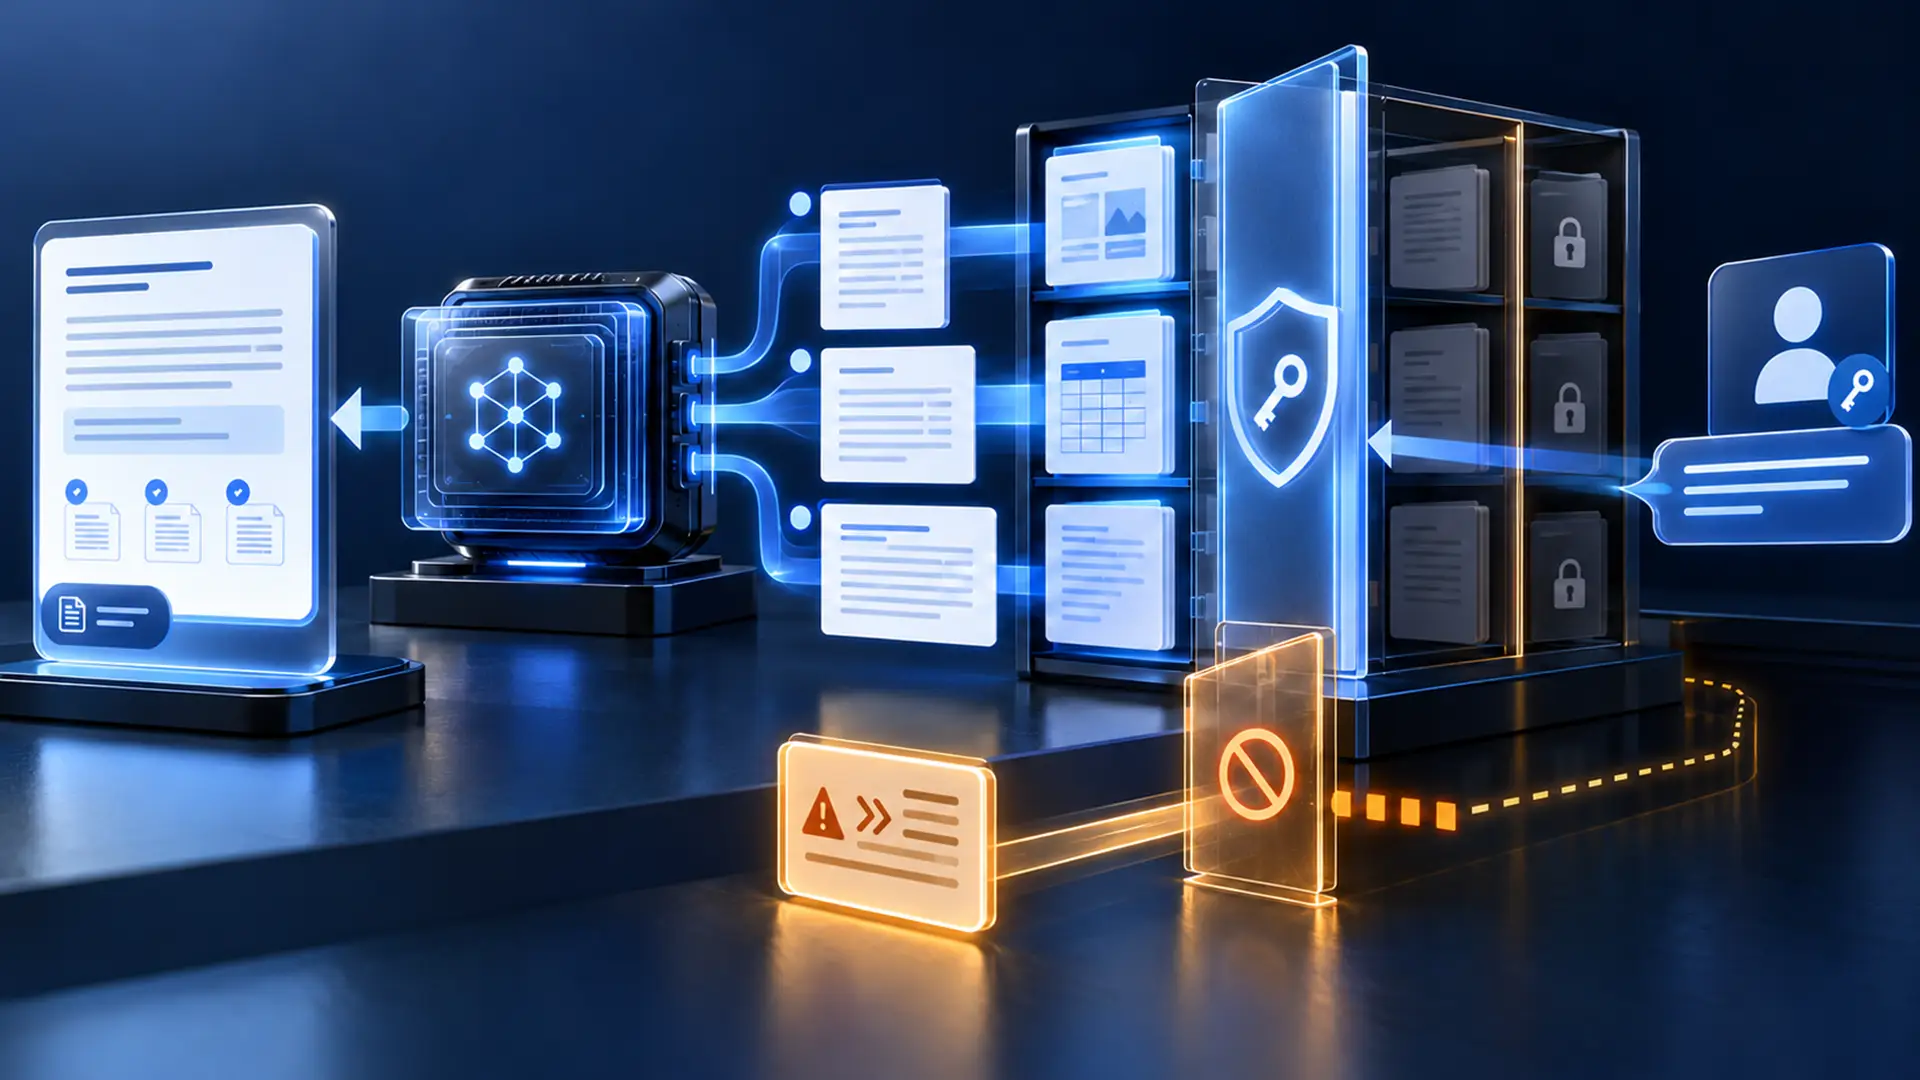
RAG مخفف Retrieval-Augmented Generation است؛ روشی که در آن، سامانه ابتدا بخش‌های مرتبط منابع را پیدا می‌کند و سپس آن‌ها را برای تولید پاسخ در اختیار مدل زبانی قرار می‌دهد. در این مسیر، لازم نیست با هر تغییر دستورالعمل، مدل از ابتدا آموزش داده شود؛ مخزن دانش و نمایه جست‌وجو باید به‌روز شوند.
کیفیت بازیابی مهم است. اگر بند مربوط به یک شرط یا استثنا پیدا نشود، پاسخ ممکن است ناقص باشد. تقسیم اسناد به بخش‌های کوچک‌تر نیز باید رابطه میان عنوان، جدول و توضیحات را حفظ کند. مستندات RAG در Microsoft ارتباط میان بازیابی محتوای مرتبط و پاسخ مبتنی بر منابع را توضیح می‌دهد.
برای بررسی راهکار، یک سؤال کاربردی بپرسید: «آیا کاربر می‌تواند ببیند این پاسخ دقیقاً به کدام بخش و نسخه سند متکی است؟» وجود لینک منبع مفید است، اما صحت استناد باید جداگانه بررسی شود.

نقش RAG در پاسخ‌گویی از اسناد چیست؟

دسترسی کاربران را تا سطح اسناد اعمال کنید

ورود به سامانه، به‌معنی مجازبودن دسترسی به تمام اطلاعات آن نیست. کارشناس فروش ممکن است به راهنمای محصول نیاز داشته باشد، اما اجازه مشاهده پرونده کارکنان را نداشته باشد. این تفاوت باید هنگام بازیابی منابع اعمال شود؛ پیش از آنکه محتوای غیرمجاز وارد متن ورودی مدل شود.

هنگام انتقال اسناد به مخزن جست‌وجو، اطلاعات مجوزها نیز باید حفظ و به‌روز شود. حذف دسترسی یک کاربر در سامانه اصلی باید در دستیار هم اثر کند. مستندات کنترل دسترسی در سطح سند این ارتباط میان هویت کاربر، مجوز سند و نتایج جست‌وجو را تشریح می‌کند.

در آزمون، یک پرسش مشابه را با حساب‌های دارای مجوزهای متفاوت مطرح کنید. نتیجه مجاز می‌تواند متفاوت باشد. سابقه گفتگو و پاسخ‌های ذخیره‌شده نیز نباید اطلاعات یک کاربر را در اختیار دیگری قرار دهند.

سیاست استفاده از ابزارهای بیرونی هم باید روشن باشد. برای این بخش، مقاله Shadow AI و خطر نشت اطلاعات سازمانی به شناخت مسئله کمک می‌کند.

متن داخل سند نباید اختیار سامانه را تغییر دهد

ممکن است یک فایل، علاوه بر اطلاعات کاری، دستورهایی برای تغییر رفتار دستیار داشته باشد. OWASP این خطر را در بحث تزریق دستور یا Prompt Injection توضیح می‌دهد و RAG را راه‌حل کامل آن نمی‌داند.
در طراحی راهکار باید محتوای بازیابی‌شده از دستورهای معتبر سامانه تفکیک شود. مجوز دسترسی به داده و ابزار نیز باید بیرون از تصمیم مدل اعمال شود؛ نوشتن «اطلاعات محرمانه را نمایش نده» جای کنترل فنی دسترسی را نمی‌گیرد.

زیرساخت را با بار کاری واقعی انتخاب کنید

تعداد کارکنان به‌تنهایی برای انتخاب سخت‌افزار کافی نیست. ممکن است فقط بخشی از آن‌ها هم‌زمان سؤال بپرسند؛ در مقابل، یک درخواست برای مقایسه چند سند طولانی، با یک پرسش کوتاه بار یکسانی ندارد.
برای برآورد اولیه، مدل انتخابی، طول معمول ورودی و پاسخ، تعداد درخواست‌های هم‌زمان و زمان پاسخ مورد انتظار را مشخص کنید. در مستندات مدیریت حافظه vLLM، اندازه مدل، طول متن قابل پردازش و تعداد درخواست‌های یک دسته از عوامل مؤثر بر مصرف حافظه‌اند. این اصل به‌معنی تأیید سازگاری یک نرم‌افزار خاص با هر دستگاه نیست.
ذخیره‌سازی اسناد، نمایه جست‌وجو و نسخه‌های پشتیبان نیز باید در برآورد دیده شود. آزمون ظرفیت را با اسناد و سؤال‌های نماینده کار روزانه انجام دهید؛ نتیجه یک نمایش کوتاه با چند سؤال آماده، ظرفیت بهره‌برداری را ثابت نمی‌کند.
در استقرار داخلی، محل اجرای همه اجزا را بررسی کنید: استخراج متن، جست‌وجو، مدل و ثبت گفتگو. داخلی‌بودن مدل به‌تنهایی روشن نمی‌کند که سایر اجزا از سرویس بیرونی استفاده می‌کنند یا خیر.

پیش از پایلوت، روش ارزیابی پاسخ را بنویسید

برای شروع، مجموعه‌ای از پرسش‌های واقعی تهیه کنید. کارشناس حوزه باید پاسخ قابل قبول و منبع آن را مشخص کند. بخشی از پرسش‌ها را برای آزمون نهایی کنار بگذارید تا نتیجه فقط نشان‌دهنده تنظیم سامانه روی مثال‌های قبلی نباشد.
سؤال‌های ساده کافی نیستند. پرسش مبهم، پاسخ وابسته به استثنا، تعارض نسخه‌ها، اطلاعات خارج از منابع و درخواست دسترسی غیرمجاز را هم بگنجانید. در موردی که منبع کافی وجود ندارد، اعلام محدودیت می‌تواند پاسخ درست باشد.

ماتریس ارزیابی پاسخ ۷ معیار برای آزمون پیش از پایلوت برای مشاهده روش بررسی و سناریوی هر معیار، آن را انتخاب کنید.
معیار ارزیابی

بازیابی

چه چیزی را بررسی کنیم؟

بخش مرتبط پیدا شده است؟

نمونه آزمون پیشنهادی

سؤال درباره یک بند در میان چند راهنمای مشابه

تفکیک کیفیت بازیابی از کیفیت پاسخ، در راهنمای ارزیابی RAG در Microsoft نیز مطرح است. جدول بالا چارچوب پیشنهادی ارزیابی پروژه است؛ حد پذیرش هر معیار باید پیش از آزمون با تیم مربوط توافق شود. میانگین خوب پاسخ‌ها، خطای افشای اطلاعات را جبران نمی‌کند.

مسئول نگهداری و به‌روزرسانی چه کسی است؟

بعد از پایلوت، دستورالعمل‌ها تغییر می‌کنند، افراد جابه‌جا می‌شوند و سؤال‌های تازه به وجود می‌آید. پیشنهاد می‌شود پیش از بهره‌برداری، مسئول تأیید دانش، مسئول فنی سرویس و مسیر گزارش پاسخ اشتباه مشخص باشند.
برای هر تغییر، اثر آن بر پاسخ‌گویی را بررسی کنید. اگر سندی حذف شد، کناررفتن آن از نتایج جست‌وجو هم باید کنترل شود. پس از تغییر مدل یا روش بازیابی، نمونه سؤال‌های مرجع دوباره اجرا شوند. درباره نگهداری گفتگوها نیز تصمیم بگیرید: چه چیزی، برای چه مدت و با دسترسی چه کسانی ثبت می‌شود؟
در هزینه پروژه، زمان آماده‌سازی اسناد، بازبینی پاسخ، نگهداری نرم‌افزار و رسیدگی به خطاها را کنار سخت‌افزار قرار دهید. این مسئولیت‌ها بخشی از بهره‌برداری روزمره‌اند.

چک‌لیست آمادگی برای جلسه بررسی راهکار

پیش از درخواست پیشنهاد فنی، این خروجی‌ها را آماده کنید. لازم نیست همه موارد بی‌نقص باشند؛ موارد نامشخص باید مسئول پیگیری داشته باشند.

READINESS OUTPUTS خروجی‌های لازم
۷ مورد

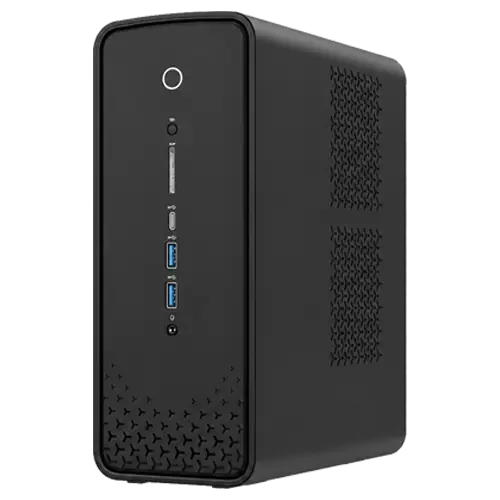
جایگاه UNIVO ACE500 در اجرای دستیار سازمانی

بهین تکنولوژی راهکار ACE500 را شامل بستر پردازشی، نرم‌افزار و خدمات راه‌اندازی معرفی کرده است. دستیار دانش سازمانی و پاسخ‌گویی از منابع داخلی، از کاربردهای مطرح‌شده برای این راهکارند. پیکربندی، قابلیت‌های نرم‌افزاری و دامنه خدمات بر اساس نیاز پروژه مشخص می‌شوند.
برای بررسی این گزینه، چک‌لیست بالا را مبنای گفتگو قرار دهید. مدل قابل اجرا، منابع قابل اتصال، روش اعمال دسترسی و ظرفیت کاربران هم‌زمان باید برای سناریوی شما روشن شوند. قابلیت یک پروژه را نباید بدون بررسی به پروژه دیگر تعمیم داد.

برای شروع چه چیزی آماده کنیم؟

یک شرح کوتاه از کاربرد، چند سند مجاز و نمونه، گروه کاربران و سؤال‌های پرتکرار تهیه کنید. این مجموعه نشان می‌دهد انتظار شما از دستیار چیست و چه چیزی باید در پایلوت اثبات شود.
برای بررسی مسیر اجرا، راهکار هوش مصنوعی سازمانی UNIVO ACE500 را ببینید و همین اطلاعات اولیه را در گفتگو با کارشناسان بهین تکنولوژی مطرح کنید تا دامنه سخت‌افزار، نرم‌افزار و خدمات متناسب با نیاز شما مشخص شود.

UNIVO PRIVATE AI

UNIVO ACE500؛ بستر فشرده برای هوش مصنوعی داخل سازمانی

ACE500 در سبد بهین تکنولوژی به‌عنوان بستر پردازشی فشرده برای راهکارهای هوش مصنوعی داخل سازمانی معرفی شده است. کاربردهای مطرح‌شده برای آن شامل اجرای مدل‌های زبانی محلی، دستیار دانش، پردازش اسناد و سناریوهای دیگر AI است.

پردازندهAMD Ryzen AI Max+ 395
حافظه یکپارچهUp to 128GB

این مشخصات، بخشی از مبنای انتخاب پیکربندی‌اند؛ اندازه مدل، تنظیمات اجرا و نیاز کاربران هم باید بررسی شوند. حافظه بیشتر به‌تنهایی، سرعت پاسخ یا ظرفیت مشخصی از کاربران هم‌زمان را تضمین نمی‌کند.

ظرفیت سخت‌افزار ≠ نتیجه تضمین‌شدهمدل، تنظیمات اجرا، نرم‌افزار و الگوی مصرف باید کنار هم ارزیابی شوند.

بهین تکنولوژی در صفحه محصول، ارائه ACE500 همراه با نرم‌افزار و خدمات راه‌اندازی را توضیح داده است. قابلیت‌های نرم‌افزاری، منابع قابل اتصال و دامنه خدمات، متناسب با نیاز سازمان در پیشنهاد فنی و تجاری مشخص می‌شوند.

برای آشنایی با این ترکیب و مطرح‌کردن کاربرد موردنظر، راهکار UNIVO ACE500 برای هوش مصنوعی سازمانی را ببینید. نقطه شروع گفت‌وگو می‌تواند یک مسئله مشخص باشد: پاسخ‌گویی از دستورالعمل‌ها، کمک به کارشناس خدمات یا استخراج اطلاعات از اسناد منتخب.

مشاهده راهکار UNIVO ACE500
Local LLMپردازش محلی مدل
RAGپاسخ متکی بر منبع
AI Agentاجرای کنترل‌شده فرایند
دستگاه UNIVO ACE500 برای راهکارهای هوش مصنوعی سازمانی

پرسش‌های متداول

آیا باید همه اسناد سازمان را از ابتدا وارد دستیار کنیم؟

خیر. برای پایلوت، منابع معتبر یک کاربرد مشخص را انتخاب کنید؛ منابعی که نیاز کاربران آزمایشی را پوشش دهند. توسعه مخزن دانش، بعد از بررسی کیفیت پاسخ و دسترسی‌ها انجام شود.

آیا برای هر تغییر در اسناد باید مدل دوباره آموزش ببیند؟

در معماری RAG، به‌روزرسانی دانش معمولاً از مسیر اصلاح منابع و نمایه جست‌وجو انجام می‌شود. نیاز به تنظیم یا آموزش تکمیلی مدل، تصمیم جداگانه‌ای است و به مسئله بستگی دارد.

آیا نمایش منبع، درست‌بودن پاسخ را تضمین می‌کند؟

خیر. ممکن است منبع مرتبط باشد، اما پاسخ یک شرط مهم را حذف یا مطلبی به آن اضافه کرده باشد. متن پاسخ و بند ارجاع‌شده باید با هم تطبیق داده شوند.

برای شروع به چند کاربر و چه سخت‌افزاری نیاز داریم؟

عدد ثابتی وجود ندارد. کاربران پایلوت باید نماینده نیازهای واقعی باشند. زیرساخت نیز با توجه به مدل، طول درخواست‌ها، استفاده هم‌زمان و نتیجه آزمون انتخاب می‌شود.

آیا استقرار داخلی، نیاز به کنترل دسترسی را از بین می‌برد؟

خیر. داخل سازمان نیز کاربران مجوزهای متفاوتی دارند. این تفاوت باید در منابع قابل بازیابی، پاسخ‌ها، سوابق گفتگو و دسترسی مدیران اعمال و آزمایش شود.

دیدگاهتان را بنویسید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

مشاوره تخصصی بهین تکنولوژی

برای انتخاب بهترین راهکار، کنار شما هستیم

اطلاعات خود را ثبت کنید تا کارشناسان بهین تکنولوژی در کوتاه‌ترین زمان با شما تماس بگیرند.

بررسی دقیق نیازهای سازمان

مشاوره تخصصی رایگان 

پیشنهاد راهکار متناسب با زیرساخت

ارتباط مستقیم با کارشناس تخصصی

در صورتی که درخواست‌تان در بخش موضوع مشاوره وجود نداشت، میتوانید در بخش توضیحات تکمیلی درخواست خود را بنویسید.

جست‌وجوی سریع

دنبال چه چیزی هستید؟

نام محصول موردنظر خود را جست‌وجو کنید.